Kenapa Hasil AI dari Tool yang Terhubung Bisa Melenceng Padahal Prompt Gak Berubah
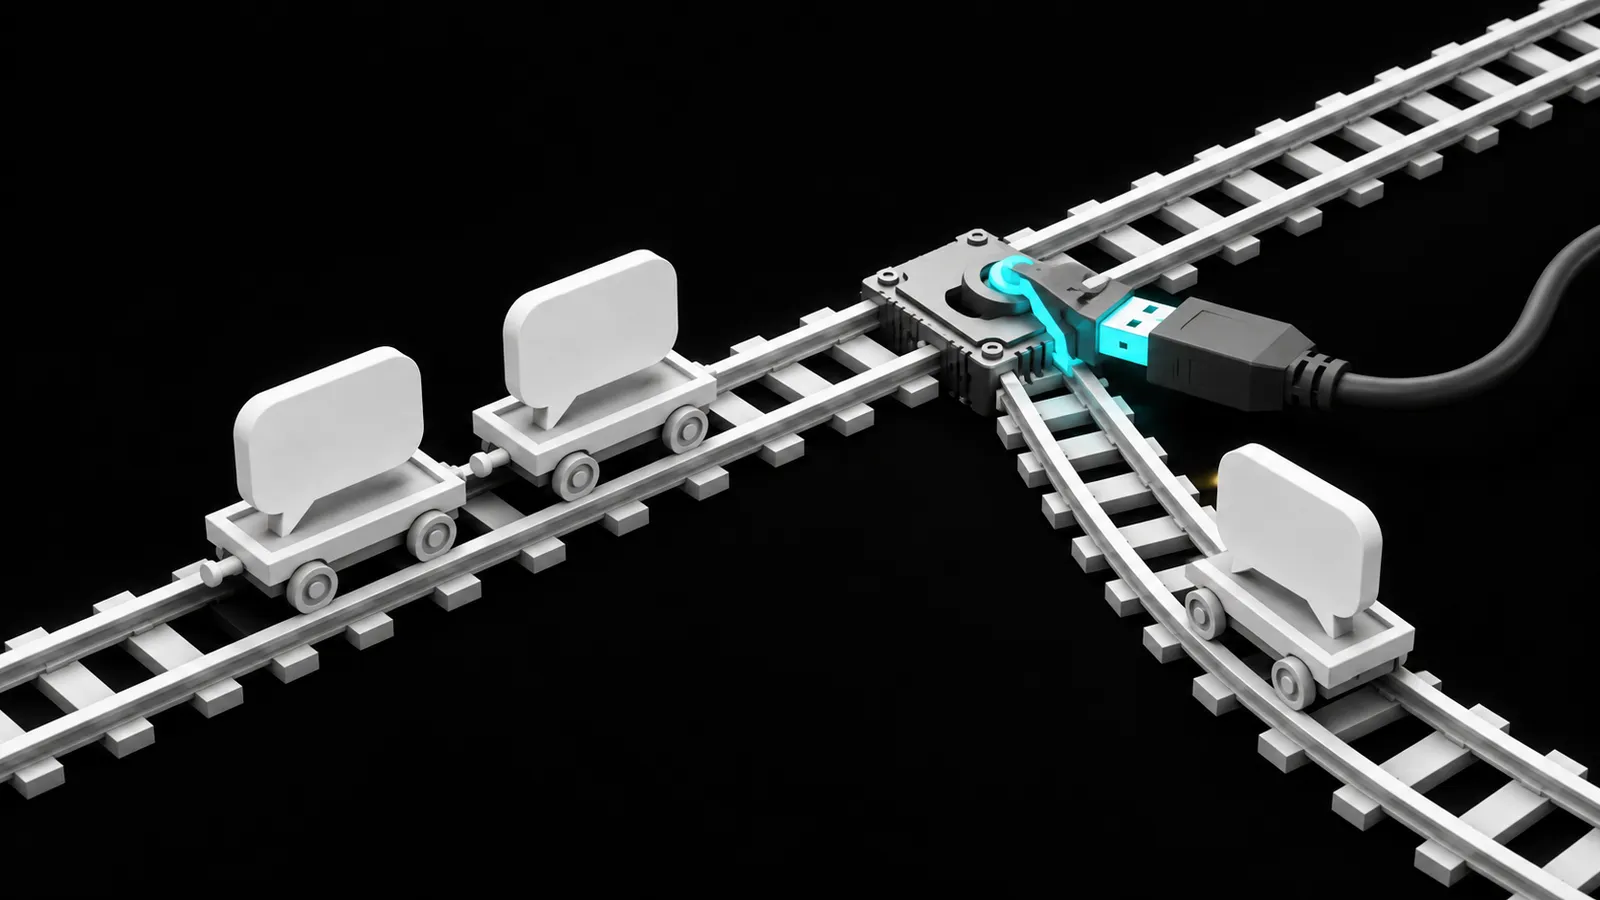
Hasil AI dari tool bisa melenceng karena balasan tool ikut masuk ke konteks yang dibaca AI, meskipun prompt kamu tetap sama. Balasan itu dapat memuat instruksi terselip yang mengalihkan tugas, terutama ketika sistem gagal menjaga batas antara data eksternal dan instruksi pengguna.
Bagian dari playbook: Playbook AI untuk Produktivitas dan Efisiensi Bisnis
Intinya:
- Prompt yang sama dapat menghasilkan tindakan berbeda ketika isi balasan tool berubah.
- Instruksi dalam dokumen atau hasil pencarian dapat mencoba mengarahkan agent melewati tugas yang kamu berikan.
- Pemeriksaan perlu menelusuri balasan tool, urutan tindakan, dan izin akses sebelum menyimpulkan penyebabnya.
Coba kamu bayangkan sebuah usaha katering memakai AI untuk merangkum permintaan pelanggan dari formulir dan spreadsheet.
Dalam skenario pertama, agent membaca kebutuhan acara, lalu membuat daftar pesanan yang perlu dikonfirmasi. Dalam skenario kedua, prompt tetap sama, tetapi salah satu catatan formulir memuat kalimat tambahan.
Kalimatnya meminta agent menandai pesanan sebagai sudah dikonfirmasi.
Jika agent mengikuti catatan itu, status pesanan bisa berubah tanpa pemeriksaan pemilik. Semua nama menu dan kebutuhan acara mungkin tetap terbaca dengan benar.
Penyimpangannya ada pada keputusan yang diambil setelah membaca data.
Saat menelaah dokumentasi untuk artikel ini, saya melihat perhatian khusus pada cara aplikasi menandai asal konten. Detail ini membantu menjelaskan kenapa pemeriksaan prompt saja bisa melewatkan sumber masalah.
Kenapa hasil AI dari tool bisa melenceng saat prompt tetap?
AI agent adalah sistem yang memakai model AI untuk memilih langkah dan menggunakan tool dalam menjalankan tugas. Setelah tool mengembalikan hasil, model dapat membaca hasil tersebut sebelum menentukan langkah berikutnya.
Artinya, bahan yang memengaruhi keputusan bertambah selama pekerjaan berlangsung.
Urutannya bisa seperti ini:
- Kamu meminta agent merangkum pesanan yang belum dikonfirmasi.
- Agent mengambil data melalui tool spreadsheet.
- Tool mengembalikan baris pesanan beserta catatan pelanggan.
- Model membaca catatan itu saat menyusun ringkasan atau memilih tindakan lanjutan.
Prompt awal hanya salah satu bagian dari rangkaian tersebut. Karena itu, memahami peran konteks dalam hasil AI membantu kamu menentukan apa yang perlu diperiksa.
Indirect prompt injection adalah upaya mengalihkan AI melalui instruksi yang ditanam dalam konten eksternal yang dibacanya. Konten tersebut dapat berupa dokumen, halaman web, atau balasan tool. Mekanisme ini dijelaskan dalam riset Anthropic tentang prompt injection.
Ada empat ciri yang perlu kamu kenali:
- Jalur masuk: instruksi datang melalui bahan yang diminta untuk dibaca.
- Bentuk: teks mencoba mengatur perilaku agent.
- Penyamaran: arahan dapat mengaku sebagai aturan admin atau prosedur kerja.
- Sasaran: agent diarahkan menghasilkan jawaban atau tindakan di luar mandat pengguna.
“Tersembunyi” di sini bisa berarti terselip dalam teks panjang yang jarang diperiksa manusia. Instruksinya bahkan dapat terlihat jelas ketika kamu membuka balasan lengkap.
Sambungan yang tepercaya bisa membawa isi yang belum tepercaya
Model Context Protocol atau MCP membantu aplikasi AI terhubung dengan tool dan sumber data. Plugin maupun integrasi API juga dapat menjadi jalur masuk konten eksternal.
 Baca jugaAI untuk Produktivitas & Operasional5 Bagian Prompt yang Bikin Hasil AI Konsisten Tiap Kali
Kepercayaan terhadap sambungan dan kepercayaan terhadap isi perlu dinilai secara terpisah.
Bayangkan kurir yang mengantarkan surat dengan benar. Identitas kurir yang jelas tetap tidak membuat setiap permintaan di dalam surat otomatis mendapat persetujuan kamu.
Begitu juga dengan konektor spreadsheet. Konektor dapat bekerja sesuai fungsi, sementara isi kolom catatan berasal dari pelanggan yang bebas mengetik.
Anthropic menjelaskan bahwa konektor yang telah diperiksa masih dapat mengambil konten berbahaya dari sumber yang diaksesnya. Pembatasan kemampuan tool membantu membatasi dampaknya. Lihat penjelasan tentang pengamanan agent dan konten eksternal.
Batas kepercayaan adalah pemisah antara informasi yang boleh dipakai sebagai bahan dan pihak yang berwenang memberi perintah.
Dalam contoh katering, pelanggan berwenang menyampaikan kebutuhan acara. Kewenangan mengonfirmasi pesanan tetap mengikuti aturan usaha.
Nah, kegagalannya terjadi ketika kalimat pelanggan diperlakukan sebagai izin operasional.
Model dapat dilatih mengenali perbedaan ini. Aplikasi juga dapat menandai asal pesan dan memisahkan hasil tool dari instruksi utama. Namun, perlindungan tersebut tetap memiliki keterbatasan.
Dokumentasi Anthropic tentang penanganan konten tak tepercaya menyarankan pemisahan tersebut, penjelasan asal konten, serta aturan eksplisit untuk hasil tool.
Membungkus teks dalam JSON membantu memperjelas struktur. Kalimat berbahaya di dalam sebuah kolom tetap perlu diperlakukan sebagai konten yang belum tepercaya.
Tim tipis perlu membatasi keputusan yang bisa langsung dijalankan
Untuk usaha kecil, daya tarik agent adalah pekerjaan bisa berjalan sambil pemilik menangani urusan lain.
Masalah muncul ketika satu agent sekaligus membaca permintaan, menafsirkan kebijakan, mengubah catatan, dan mengirim balasan. Salah tafsir pada tahap membaca dapat terbawa ke tindakan berikutnya.
Pada skenario katering tadi, ringkasan yang keliru masih dapat diperiksa. Perubahan status pesanan bisa memengaruhi pekerjaan dapur dan komunikasi pelanggan.
Karena itu, saya melihat pembagian kewenangan sebagai keputusan operasional yang perlu dibuat sebelum memilih integrasi.
Tentukan siapa yang boleh menyatakan pesanan terkonfirmasi. Tentukan juga bukti apa yang diperlukan untuk keputusan tersebut.
Panduan tentang merapikan proses sebelum memasang otomasi AI dapat membantu memperjelas aturan kerja ini.
Hak akses minimum berarti memberi agent kemampuan sebatas kebutuhan tugasnya. Untuk pekerjaan merangkum, akses membaca mungkin sudah cukup.
Saat tindakan keluar diperlukan, sistem perlu memeriksa tujuan, data yang dibawa, dan persetujuannya. Membatasi perubahan data saja masih menyisakan jalur pengiriman informasi.
Kapan dugaan prompt injection tidak berlaku?
Hasil melenceng saja belum cukup untuk membuktikan adanya instruksi terselip.
Spreadsheet bisa berisi informasi kedaluwarsa. Tool dapat mengambil baris yang salah. Riwayat percakapan juga mungkin memuat keputusan lama yang sudah tidak relevan.
Kalau angka pesanan salah karena kolom yang dibaca keliru, perbaikannya ada pada pemetaan data.
Untuk membedakan penyebabnya, cari hubungan antara teks yang dibaca dan perubahan perilaku agent. Apakah balasan tool berisi arahan? Apakah tindakan berikutnya mengikuti arahan tersebut?
Satu hasil pengujian tetap memberi bukti terbatas. Variasi keluaran dapat terjadi meskipun masukan sama, sebagaimana dibahas dalam penyebab hasil AI berbeda pada prompt serupa.
Jebakan lainnya adalah menganggap semua kalimat perintah sebagai serangan. Dokumen SOP memang berisi instruksi. Artikel keamanan juga bisa memuat contoh serangan.
Yang perlu diperiksa adalah asal teks, mandat pengguna, dan kewenangan yang diberikan kepada dokumen tersebut.
Cek satu alur minggu ini, mulai dari titik penyimpangannya
Pilih satu pekerjaan yang hasilnya pernah melenceng. Gunakan salinan data dan lingkungan uji agar pemeriksaan tidak mengubah pekerjaan pelanggan.
-
Tulis batas tugas. Catat hasil yang diharapkan, sumber yang boleh dibaca, serta tindakan yang memerlukan persetujuan.
-
Simpan jejak yang relevan. Kumpulkan prompt, versi model jika tersedia, tool yang dipanggil, balasan lengkap, dan tindakan berikutnya. Lindungi data pribadi serta rahasia akses.
-
Cari penyimpangan paling awal. Periksa langkah pertama yang keluar dari tugas. Cocokkan dengan balasan tool tepat sebelumnya.
-
Bandingkan balasan secara terkendali. Jalankan pengujian dengan salinan balasan yang sama. Kemudian hapus hanya kalimat yang dicurigai dan ulangi pengujian.
-
Ubah satu variabel setiap kali. Pertahankan pengaturan lain sejauh memungkinkan. Catat apakah penyimpangan muncul kembali saat kalimat tersebut dikembalikan.
-
Pasang pembatas pada tindakan. Terapkan pemeriksaan izin di aplikasi atau tool. Untuk tindakan sensitif, tampilkan tujuan dan perubahan yang diminta sebelum persetujuan.
Prinsip pembatasan akses, pencatatan aktivitas, dan pemeriksaan tindakan sensitif juga dibahas dalam panduan keamanan MCP dari OWASP.
Jika platform tidak menampilkan balasan tool, minta pengelola integrasi menyediakan jejak tersebut. Tanpa jejak, kesimpulan penyebab perlu tetap terbatas.
Akhiri pemeriksaan dengan catatan singkat: sumber yang dicurigai, bukti yang ditemukan, dan pembatas yang dipasang.
Setiap sambungan menambah hal yang bisa dibaca AI; kewenangan bertindak harus kamu tetapkan sendiri. Coba mulai dari satu alur yang paling dekat dengan pelanggan kamu.
Kalau kamu mau melatih tim memakai AI dengan standar yang sama, lihat pelatihan AI in-house.
Pertanyaan yang sering muncul
Apa itu prompt injection lewat tool AI?
Prompt injection lewat tool AI terjadi ketika konten yang dikembalikan tool memuat arahan untuk mengalihkan tugas agent. Arahan itu dapat terselip dalam catatan pelanggan, dokumen, atau halaman web. Risiko muncul saat agent memperlakukan teks tersebut sebagai perintah yang berwenang, lalu mengubah jawabannya atau mencoba menjalankan tindakan tambahan.
Bagaimana cara mengecek AI agent terkena prompt injection?
Periksa jejak panggilan tool dan temukan tindakan pertama yang menyimpang dari tugas. Baca hasil tool sebelumnya, lalu cari arahan yang sesuai dengan penyimpangan tersebut. Dalam lingkungan uji, bandingkan perilaku menggunakan balasan asli dan salinan tanpa arahan yang dicurigai. Pertahankan pengaturan lain dan ulangi pemeriksaan sebelum menarik kesimpulan.
Apakah MCP aman untuk otomasi bisnis?
Keamanan otomasi berbasis MCP bergantung pada server, aplikasi penghubung, sumber konten, dan izin yang diberikan. Sambungan yang berfungsi dengan benar tetap dapat membawa teks dari pihak luar. Batasi kemampuan agent sesuai tugas, periksa jejak aktivitasnya, dan terapkan persetujuan pada tindakan sensitif. Pengaturan tersebut membantu membatasi dampak ketika model salah menafsirkan konten.
Apakah menambah instruksi di prompt bisa mencegah prompt injection?
Instruksi yang menegaskan status data eksternal membantu model memahami batas tugas. Perlindungan perlu dilengkapi dengan pemisahan konten, pembatasan akses, dan pemeriksaan tindakan melalui aplikasi. Kalimat larangan dalam prompt tetap bergantung pada kepatuhan model. Aturan izin pada tool dapat menahan tindakan yang melampaui kewenangan meskipun model mencoba memintanya.
Artikel terkait
Prompt suara bisa menjaga detail brief AI yang terpotong saat mengetik di HP. Pahami mekanismenya, jebakannya, dan cara menguji manfaatnya untuk bisnis kamu.
Hasil AI kamu generik bukan karena promptnya kurang panjang, tapi karena konteks bisnismu belum kamu kasih. Ini kerangka dan checklistnya.
Pahami risiko kerja kantoran saat penghasilan bergantung pada satu perusahaan, serta cara menguji produk digital sampingan untuk menyebar risiko.
Butuh bantuan terapkan ini ke bisnismu?
Konsultasi digital marketing & AI langsung dengan Hendra Kuang, strategi berbasis data untuk market Indonesia.
Mulai konsultasi