Kenapa Urutan Contoh di Dalam Prompt AI Bisa Mengubah Akurasi Jawaban Drastis
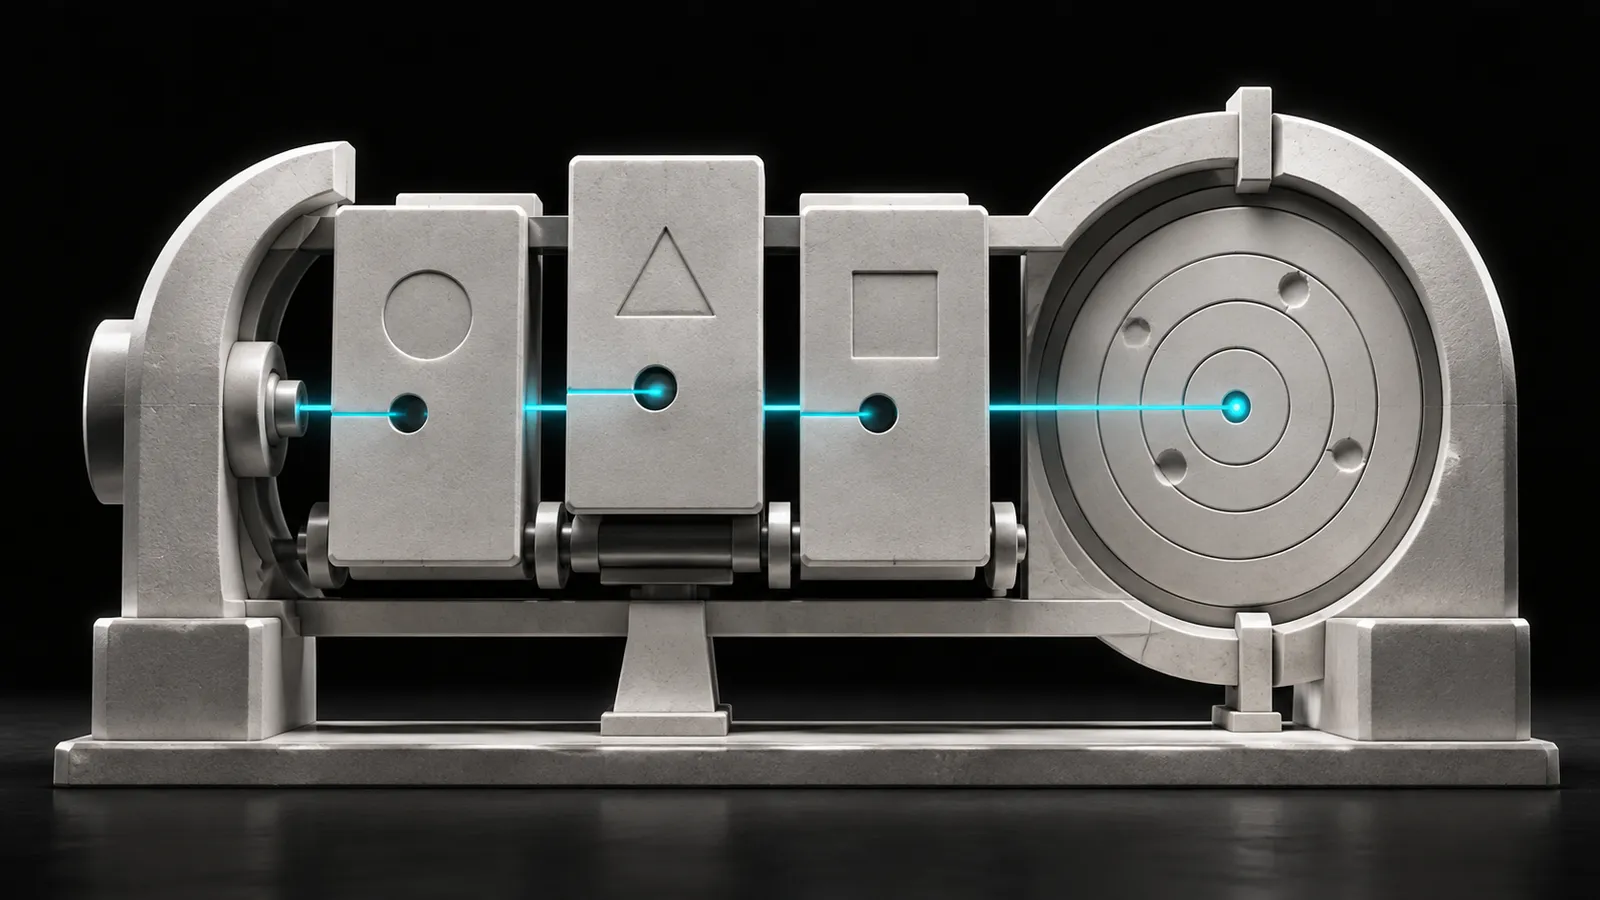
Urutan contoh di dalam prompt mengubah jawaban karena model membaca semua contoh sebagai satu rangkaian konteks, dan contoh yang posisinya paling dekat dengan pertanyaan punya pengaruh paling besar terhadap jawaban. Isi contoh yang sama persis, disusun dengan urutan berbeda, bisa menghasilkan tingkat akurasi yang jauh berbeda.
Bagian dari playbook: Playbook Prompt ChatGPT
Intinya:
- Model memberi bobot lebih besar pada contoh terakhir sebelum pertanyaan, jadi contoh penutup ikut menentukan bentuk dan isi jawaban.
- Kalau mayoritas contoh punya label atau nada yang sama, model cenderung mengulang pola mayoritas itu pada kasus baru yang ambigu.
- Urutan contoh layak diperlakukan sebagai variabel yang diuji, memakai set soal kecil yang jawaban benarnya sudah kamu tahu.
Dua prompt yang isinya identik, hasilnya beda
Coba kamu bayangin punya toko online kecil. Kamu bikin prompt untuk memilah pesan masuk jadi dua kategori: “Keluhan” dan “Pertanyaan”. Kamu kasih empat contoh di dalam prompt.
Prompt A susunannya begini: contoh Keluhan, contoh Keluhan, contoh Pertanyaan, contoh Pertanyaan. Prompt B pakai empat contoh yang sama, cuma dibalik: Pertanyaan, Pertanyaan, Keluhan, Keluhan.
Lalu masuk pesan abu-abu, misalnya “Halo, paket saya statusnya masih di gudang, biasanya berapa lama ya?”. Pesan ini duduk di tengah. Ada nada tanya, ada sinyal kecewa.
Prompt A punya kecenderungan menutup dengan pola Pertanyaan. Prompt B menutup dengan pola Keluhan. Pesan abu-abu tadi punya peluang lebih besar ikut label penutup masing-masing prompt. Kamu tidak mengganti satu kata pun dalam instruksi. Yang berubah cuma antrean contohnya.
Kalau kamu mengklasifikasi ratusan pesan per minggu, selisih kecil di kasus abu-abu itu menumpuk jadi laporan yang salah arah.
Kenapa urutan contoh dalam prompt AI mempengaruhi hasil jawaban
Model bahasa bekerja dengan memprediksi kelanjutan teks berdasarkan seluruh teks sebelumnya. Contoh yang kamu tempel di prompt masuk sebagai bukti. Model menyimpulkan aturan mainnya dari susunan bukti itu, lalu menerapkan aturan tersebut ke input baru.
 Baca jugaPrompt & ChatGPTContoh Prompt Kasus Bisnis yang Optimal, dan yang Meleset
Few-shot prompting adalah cara memberi model beberapa pasangan contoh input dan output di dalam prompt, supaya model meniru pola itu pada input berikutnya. Atributnya: contohnya hidup di dalam prompt, jumlahnya terbatas, formatnya seragam, dan urutannya ikut terbaca sebagai informasi.
Sensitivitas urutan contoh adalah perubahan kualitas jawaban yang muncul hanya karena susunan contoh diubah, padahal isi contohnya sama persis. Fenomena ini terdokumentasi di literatur prompting. Salah satu rujukan primer yang membahasnya adalah Fantastically Ordered Prompts and Where to Find Them, yang menunjukkan performa few-shot bisa bergerak jauh hanya karena permutasi urutan contoh.
Contoh terakhir dibaca sebagai aturan paling baru
Recency bias adalah kecenderungan model condong ke pola yang muncul paling dekat dengan pertanyaan. Posisi akhir itu tetangga langsung dari input yang mau dijawab. Model membaca pola di sana sebagai instruksi paling relevan.
Efeknya kelihatan di tiga hal:
- Label atau keputusan yang dipakai contoh terakhir lebih sering diulang.
- Panjang jawaban ikut menyerupai contoh terakhir.
- Gaya bahasa, tingkat formalitas, dan struktur kalimat menempel dari contoh penutup.
Label yang menumpuk bikin model berhenti menimbang
Majority label bias adalah kecenderungan model memilih label yang paling sering muncul di deretan contoh. Kalau dari enam contoh ada lima berlabel “Keluhan”, model menangkap sinyal bahwa dunia ini mayoritas keluhan. Kasus abu-abu akan tertarik ke sana.
Ini sering terjadi tanpa disadari. Kamu ambil contoh dari data asli, dan data asli memang timpang. Ketimpangan itu ikut masuk ke prompt sebagai bias.
Urutan juga mengajarkan format, tidak cuma isi
Kalau contoh pertama jawabannya satu kalimat dan contoh terakhir jawabannya lima poin, model biasanya mengikuti yang terakhir. Ini bagian yang paling sering bikin orang bingung. Mereka merasa promptnya sudah minta format tertentu, padahal contoh terakhir diam-diam mengajarkan format lain. Prinsip ini nyambung dengan alasan kenapa konteks yang tepat mengalahkan prompt yang panjang: yang menentukan hasil adalah apa yang model lihat, bukan seberapa banyak kata yang kamu tulis.
Kenapa ini penting kalau timmu tipis
Bisnis kecil jarang punya orang khusus untuk mengurus kualitas output AI. Prompt dipakai berulang, sering ditempel ke SOP, kadang dibagikan ke admin dan freelancer. Satu prompt yang urutan contohnya kebetulan buruk akan memproduksi kesalahan yang sama setiap hari, diam-diam, tanpa alarm.
Yang bikin repot: kesalahannya masuk akal. Jawabannya terdengar rapi, jadi tidak ada yang curiga. Kamu baru sadar pas laporan bulanan tidak cocok dengan keluhan yang masuk ke WhatsApp.
Beberapa titik kerja di mana urutan contoh paling terasa:
- Klasifikasi pesan masuk, review produk, dan lead dari iklan.
- Ekstraksi data terstruktur dari chat, misalnya nama, alamat, dan jenis produk.
- Penulisan caption atau balasan template yang harus konsisten nadanya.
- Penilaian internal, misalnya menandai lead panas dan lead dingin.
Untuk pekerjaan ekstraksi yang butuh keluaran presisi, gabungkan ini dengan teknik menyusun prompt agar jawabannya spesifik supaya bentuk keluarannya terkunci dari dua sisi.
Jebakannya: ini tidak selalu jadi masalah
Sensitivitas urutan mengecil di beberapa kondisi. Kamu tidak perlu ribet kalau situasimu masuk daftar ini:
- Tugasnya generatif bebas, misalnya brainstorming ide konten. Tidak ada jawaban benar, jadi variasi justru berguna.
- Contohnya cuma satu. Tidak ada urutan yang bisa diacak.
- Semua contoh homogen dan seimbang, tiap kategori porsinya sama dan formatnya identik.
- Instruksinya sudah sangat eksplisit dengan kriteria terukur, sehingga aturan mengalahkan tebakan pola.
Jebakan berikutnya: orang lalu mengejar urutan sempurna dan lupa memperbaiki isi contohnya. Urutan itu pengungkit kecil. Contoh yang buruk tetap buruk di urutan mana pun. Perbaiki kualitas dan keterwakilan contoh dulu, baru rapikan susunannya.
Jebakan ketiga: urutan terbaik di satu model belum tentu terbaik di model lain. Ganti model, ulangi pengecekan singkat.
Yang bisa kamu lakukan minggu ini
Ambil satu prompt yang paling sering dipakai di bisnismu. Lalu jalankan lima langkah ini.
 Baca jugaPrompt & ChatGPTKasih Contoh Jawaban Salah ke AI Secara Sengaja, Biar Hasilnya Lebih Akurat
- Kumpulkan 15 sampai 20 kasus nyata yang jawaban benarnya sudah kamu tahu. Ini set uji kecilmu.
- Hitung komposisi contoh di promptmu. Kalau satu kategori mendominasi, seimbangkan porsinya.
- Bikin tiga versi prompt dengan isi contoh identik dan urutan berbeda. Selang-seling kategorinya di salah satu versi.
- Jalankan ketiga versi ke set uji tadi, catat berapa yang benar di masing-masing versi. Cukup pakai spreadsheet.
- Kunci versi pemenang, simpan sebagai template resmi, dan catat tanggal pengujiannya di dokumen internal.
Tambahan kecil yang sering membantu: taruh contoh yang paling mirip dengan kasus sulitmu di posisi terakhir. Kalau tim kamu juga pakai persona di dalam prompt, cek ulang interaksinya dengan cara role-playing memperdalam jawaban AI, karena peran dan contoh saling menarik output ke arah berbeda.
Satu hal yang saya harap nempel: contoh di dalam prompt itu data latih mini. Kamu sedang mengajari model dalam hitungan detik, dan urutan penyajian termasuk materi ajarnya. Perlakukan prompt seperti aset yang diuji, dengan catatan versi dan bukti, sama seperti kamu menguji headline iklan.
Kalau tim kamu mau punya cara kerja yang seragam dalam menguji dan merapikan prompt, itu yang saya bahas di pelatihan AI untuk tim. Kamu juga bisa mulai sendiri minggu ini dengan lima langkah di atas.
Pertanyaan yang sering muncul
Apakah urutan contoh dalam prompt benar-benar berpengaruh ke jawaban AI?
Ya, berpengaruh. Model membaca contoh sebagai rangkaian bukti dan menyimpulkan pola dari susunannya. Contoh yang posisinya paling dekat dengan pertanyaan cenderung paling menentukan label, format, dan gaya jawaban. Efeknya paling terasa pada tugas berjawaban tetap seperti klasifikasi dan ekstraksi data. Pada tugas generatif bebas seperti brainstorming, pengaruhnya jauh lebih kecil.
Sebaiknya contoh terbaik ditaruh di awal atau di akhir prompt?
Taruh contoh yang paling mewakili kasus sulitmu di posisi akhir, tepat sebelum input yang mau dijawab. Posisi itu terbaca model sebagai acuan paling relevan. Pastikan juga komposisi kategorinya seimbang dan diselang-seling, supaya model tidak menyimpulkan satu kategori sebagai jawaban default. Uji dua sampai tiga susunan sebelum mengunci satu versi.
Berapa contoh yang ideal dimasukkan ke dalam satu prompt?
Mulai dari tiga sampai enam contoh untuk kebanyakan tugas bisnis, lalu tambah hanya kalau akurasinya masih kurang. Prioritaskan keragaman kasus dibanding jumlah. Contoh yang mirip satu sama lain menambah panjang prompt tanpa menambah informasi. Pastikan setiap kategori terwakili, termasuk kasus abu-abu yang sering bikin salah klasifikasi.
Bagaimana cara menguji apakah urutan contoh saya sudah bagus?
Siapkan 15 sampai 20 kasus nyata yang jawaban benarnya sudah kamu ketahui. Buat beberapa versi prompt dengan isi contoh identik dan urutan berbeda. Jalankan semuanya ke kasus yang sama, lalu hitung berapa jawaban yang tepat per versi. Simpan versi dengan skor tertinggi sebagai template resmi, dan ulangi pengujian setiap kali kamu ganti model.
Artikel terkait
Cara membuat prompt AI yang mengikat hasil ke audiens dan tujuan bisnis spesifik, lengkap langkah praktis untuk promosi produk, portofolio, dan brainstorming.
Contoh jawaban salah yang disandingkan dengan contoh benar bikin hasil AI lebih akurat. Pahami mekanismenya, cara menyusunnya, dan jebakan yang perlu dihindari.
Jawaban AI bisa terdengar runut dan meyakinkan tapi tetap salah karena asumsi awalnya keliru. Ini cara mengenali dan mengecek asumsi itu sebelum ambil...
Butuh bantuan terapkan ini ke bisnismu?
Konsultasi digital marketing & AI langsung dengan Hendra Kuang, strategi berbasis data untuk market Indonesia.
Mulai konsultasi